segunda-feira, 3 de novembro de 2008

SQL Server 2008 SSIS – Data Profile

O SQL Server 2008 trás uma nova tarefa no Control Flow para analisar os dados durante a carga. O Data Profile pode fazer até 8 análises nos dados gerando um relatório em XML, que pode ser visualizado em um novo aplicativo chamado Data Profile Viewer.

As 8 análises disponibilizadas pelo Data Profile podem ser divididas em dois grupos: analise do relacionamento entre colunas e analise individua de colunas.

Análise do relacionamento entre colunas:
Candidate Key
– analisa se uma ou mais colunas podem ser utilizadas como chave, ou analisa se existem valores duplicados onde se espera unicidade.

Functional Dependency – analisa a dependência funcional entre colunas, por exemplo ocorrência de cidades em estados.

Value Inclusion – verifica relacionamento tipo Foreign Key entra colunas de tabelas diferentes, exemplo de ocorrência de código de cliente nas tabelas de vendas e cliente.

Análise individual das colunas:
Column Length Distribution – relação dos tamanhos distintos de string em uma coluna e o percentual de linhas de cada tamanho. Útil para identificar possíveis erros nos dados.

Column Null Ratio – retorna o percentual de ocorrências de NULL em uma coluna.

Column Pattern – retorna um conjunto de expressões regulares identificadas e o percentual de linhas de cada ocorrência.

Column Statistics – só aplicável a colunas numéricas, mostra: Min, Max, Média e Desvio Padrão.

Column Value Distribution – retorna todos os valores distintos de uma coluna e o percentual de linhas de cada ocorrência.

Tipos de dados indicados:


Você poderá combinar várias análises em uma única tarefa Data Profile, veja na imagem abaixo:

O arquivo XML gerado após a análise poderá ser visualizado com o utilitário Data Profile Viewer localizado no grupo de programas do SQL Server 2008 no submenu Integration Services. O exemplo abaixo mostra uma análise de distribuição de valores (Column Value Distribution Profile):

Até o próximo Post,
Landry.

SQL Server 2008 Community Launch

Lançamento do SQL Server 2008 no Brasil

O SQL Server Community Launch irá ocorrer simultaneamente em vários locais no Brasil durante o mês de Novembro de 2008, veja no link abaixo:

http://www.bufaloinfo.com.br/sqllaunch/mapa.htm

Estaremos confirmando o evento na Allen no sábado dia 8 de Novembro ou no seguinte, aguardem próximo post.

Landry

terça-feira, 21 de outubro de 2008

SQL Server 2008 SSIS - Pipeline Scalability

No post Escolha das Transformacoes SSIS (http://sqlserver-brasil.blogspot.com/2008/06/classificando-as-transformaes-no-data.html) escrevi sobre a classificação das transformações em 3 grandes grupos: com bloqueio, sem bloqueio e semi bloqueio.

As transformações sem bloqueio consecutivas em um Data Flow formam uma única árvore de execução, utilizando o mesmo worker thread. Toda vez que em um Data Flow temos uma transformação com bloqueio ou semi bloqueio, é iniciada uma nova árvore de execução, utilizando um novo worker thread. Veja no Data Flow abaixo a divisão em árvores de execução:


Esta divisão em mais de um worker thread proporciona a execução em paralelo em máquinas com mais de um processador, melhorando o desempenho da carga.

Uma técnica utilizada no SQL Server 2005 era acrescentar ao Data Flow uma transformação semi bloqueio (exemplo UNION All) para forçar o uso de um novo worker thread, e melhorar o paralelismo.

No SQL Server 2008 o paralelismo é automático, não sendo mais necessário utilizar do artifício acima para melhorar o desempenho. Para controlar o uso de worker threads basta ajustar a propriedade do Data Flow EngineThreads,

Por outro lado isto nos força a rever os pacotes desenvolvidos no SQL Server 2005 utilizando o artifício descrito acima!

Até o próximo post,
Landry.

sábado, 11 de outubro de 2008

Novidades do SQL Server 2008 para Business Intelligence

Estou iniciando uma série de posts com as novidades do SQL Server 2008 para Business Intelligence, pois estarei participando do evento SQL Launch no Rio de Janeiro com duas palestras sobre SSIS e SSAS. Segue abaixo a relação das novas funcionalidades e melhorias que farão parte dos próximos posts:

SSIS
SSIS pipeline.
SSIS persistent lookups.
SSIS data profiling.
CDC (Change Data Capture).

SSRS
Integração com SharePoint nativo.
Novo Data Region Tablix.
Novos formatos de Rendering: rich-text, Word.

Melhorias no formato de Rendering Excel.
Entrega dos relatórios diretamente para o SharePoint.

SSAS
Personalization Extensions .
Best Practice Alerts.
Dynamic Named Sets.
Enhanced Dimension Design.
Enhanced Aggregate Design.
Novos algoritmos para Microsoft Time Series.
Subspace Computation.
MOLAP Write Back.
Scale-Out.
Backup.

Até o próximo post,
Landry

sábado, 27 de setembro de 2008

Resource Database e Tabelas de Sistema

Olá... depois de quase um mês sem fazer um post voltei... estava estudando para as provas Beta de SQL Server 2008. Estou aproveitando um intervalo de duas semanas entre as provas para escrever este post, espero que gostem!

No SQL Server 2000 era comum o acesso direto as tabelas de sistema para obter informações de metadata e até em situações extremas atualizá-las (SP_configure ‘allow updates’,1). No SQL Server 2005 todas as tabelas de sistema estão escondidas, todo o acesso ao metadata fica restrito as Stored Procedures, funções e Visões de sistema! Veja no link abaixo o diagrama das visões de sistema que podemos utilizar para acessar metadata:

SQL Server 2005 System Views Map
http://www.microsoft.com/downloads/details.aspx?FamilyID=2ec9e842-40be-4321-9b56-92fd3860fb32&displaylang=en

Para acessar as tabelas de sistema temos que abrir uma conexão DAC (Dedicated Administrator Connection), colocando ADMIN: na frente do nome da instância na conexão da janela de query no SSMS. A relação das tabelas de sistema pode ser encontrada no BOL pesquisando por “System Base Tables”.

O SQL Server 2005 introduziu um novo Banco de Dados de Sistema chamado mssqlsystemresource. Este banco contém os objetos de sistema que aparecem no schema SYS nos demais bancos de dados: Views, Stored Procedures e Funções de sistema (não contém tabelas de sistema).

O Banco de Dados mssqlsystemresource fica escondido, não aparece na lista de bancos no SSMS, porém se você navegar até a pasta abaixo verá os dois arquivos deste banco: mssqlsystemresource.mdf e mssqlsystemresource.ldf.
\Microsoft SQL Server\MSSQL.1\MSSQL\Data

Temos algumas opções para os curiosos...

1) Iniciar a Instância em modo monousuário:
- Basta parar o serviço e iniciar utilizando o comando abaixo no prompt de comando:
cd c:\Program Files\Microsoft SQL Server\MSSQL.1\MSSQL\Binn
sqlservr.exe –c -m

Depois é só conectar no Banco e explorar seu conteúdo, veja na figura abaixo:


2) Utilizar os arquivos de dados e log do banco mssqlsystemresource para fazer Attach com outro nome de Banco:
- Copiar os arquivos de dados e log para outra pasta (não precisa parar o serviço).
- Executar o script abaixo (não se esqueça de alterar o caminho dos arquivos de dados e log!):

USE master
go
CREATE DATABASE mssqlsystemresource_Teste ON
( FILENAME = 'C:\mssqlsystemresource.mdf' ),
( FILENAME = 'C:\mssqlsystemresource.ldf' )
FOR ATTACH
go
if not exists (select name from master.sys.databases sd where name = N'mssqlsystemresource_Teste' AND
SUSER_SNAME(sd.owner_sid) = SUSER_SNAME() )
EXEC mssqlsystemresource_Teste.dbo.sp_changedbowner @loginame=N'sa', @map=false
go


Mssqlsystemresource facilita a execução dos Service Packs
Em versões anteriores do SQL Server, os Service Packs tinham que executar vários scripts que alteravam os objetos de sistema em todos os banncos de dados. Dependendo do tamanho do servidor, estes scripts demoravam para rodar, aumentando o período de indisponibilidade do servidor. Centralizando o metadata no mssqlsystemresource, fica muito mais fácil para um Service Pack realizar as alterações necessárias, basta substituir os arquivos de dados e log do banco, reduzindo o tempo total de execução!

Backup do Banco de Dados Mssqlsystemresource
Como todos os objetos de sistema ficam agora no banco de dados mssqlsystemresource, ocorrendo qualquer problema nos seus arquivos o serviço do SQL Server não irá reiniciar. Veja a mensagem de erro no Event Viewer abaixo:
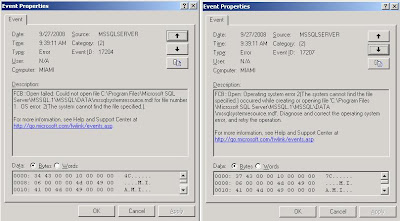

Sendo assim, é indicado o Backup do Banco de Dados mssqlsystemresource, juntamente com master e msdb. O problema é que o SQL Server não permite Backup no banco mssqlsystemresource, contudo é o único banco que permite a cópia dos seus arquivos de dados e log com o serviço ativo. O Restore também pode ser feito com uma cópia, porém tem que parar o serviço do SQL Server.

Existem duas instruções que retornam informações do banco mssqlsystemresource o Build e data de alteração respectivamente:
SELECT SERVERPROPERTY('ResourceVersion')
SELECT SERVERPROPERTY('ResourceLastUpdateDateTime');

Até o próximo post,
Landry.

segunda-feira, 18 de agosto de 2008

T-SQL: CROSS APPLY

Prosseguindo na série com as instruções novas no SQL Server 2005, vou mostrar neste post o CROSS APPLY. Em uma operação de JOIN (INNER, OUTER ou CROSS) o T-SQL não aceita subquery correlacionada em tabela derivada, veja os exemplos abaixo:

select A.col, b.col
from A
cross join (select B.col from B where B.val=A.val) b
-- Erro, A.val na subquery está fora de escopo!

A instrução acima deverá ser reescrita em uma das forma abaixo, utilizando subquery como tabela derivada:

select A.col, b.col
from A
cross join (select B.col,B.val from B) b
where B.val=A.val
OU
select A.col, b.col
from A join (select B.col,B.val from B) b
on B.val=A.val


O problema persiste quando tentamos utilizar uma Função Definida pelo Usuário (UDF), porque A.val como parâmetro da função está fora de escopo!

select A.*, B.col from A
cross join dbo.UDF(A.val) B

O novo CROSS APPLY do SQL Server 2005 resolve este problema, aceitando a instrução abaixo:

select A.*, B.col from A
CROSS APPLY dbo.UDF(A.val) B

Vamos criar duas tabelas e uma função para trabalharmos em um exemplo real:

use TempDB
go
create table Cliente(ClientePK int NULL,Nome varchar(30) NULL)
create table Vendas(VendasPK int NULL,ClienteFK int NULL,Valor decimal(9,2) NULL)
go
insert Cliente values (1,'Jose')
insert Cliente values (2,'Maria')
insert Cliente values (3,'Ana')

insert Vendas values (1,1,20.00)
insert Vendas values (2,1,40.00)
insert Vendas values (3,2,15.00)
insert Vendas values (3,2,36.00)
go

create function fnu_MaiorVenda(@ClienteID int)
returns table as return(
select ClienteFK,Max(Valor) MaiorValor from Vendas
where ClienteFK = @ClienteID group by ClienteFK)
go

A função fnu_MaiorVenda faz um GROUP BY na tabela Vendas, retornando o valor da maior venda de um cliente identificado pelo parâmetro de entrada @ClienteID. Ao tentar executar um JOIN entre a tabela Cliente e a função fnu_MaiorVenda, recebemos o erro 4104:

select c.Nome, v.MaiorValor
from Cliente c JOIN fnu_MaiorVenda(c.ClientePK) v
on c.ClientePK = v.ClienteFK
-- Msg 4104, Level 16, State 1, Line 1
-- The multi-part identifier "c.ClientePK" could not be bound.

O CROSS APPLY resolve o problema...

select c.Nome, v.MaiorValor
from Cliente c CROSS APPLY fnu_MaiorVenda(c.ClientePK) v

Até o próximo post.
Landry.

segunda-feira, 11 de agosto de 2008

Trigger de Login

No último curso de Design de Segurança do SQL Server 2005 (curso 2790), um aluno com experiência em Oracle, perguntou se o SQL Server tinha Trigger de Login. Respondi que não tinha, porém poderíamos simular esta funcionalidade com Event Notification... o problema é que ele bloqueava o login em algumas situações, dependendo do usuário e da aplicação utilizada no login, o que seria impossível já que Event Notification é assíncrono! Uma rápida consulta na Internet mostrou uma nova funcionalidade incluída no Service Pack 2 do SQL Server 2005: Trigger de Login!

A Trigger de Login foi incluída para atender a uma certificação de segurança chamada Common Criteria (CC), resultante da união de três outras certificações: ITSEC (padrão Europeu), CTCPEC (padrão Canadense) e TCSEC (Departamento de Defesa Norte Americano). A certificação CC é reconhecida por mais de 24 países e possui 7 níveis para produtos de informática, de EAL1 a EAL7.

O SQL Server até SP1 foi classificado em EAL1, já com SP2 recebeu a classificação EAL4+ (o + indica atendimento parcial, já que a Microsoft irá melhorar o suporte em atualizações futuras). A Trigger de Login foi criada para atender os seguintes requisitos que constam no EAL4+:
Restringir a quantidade máxima de conexões concorrentes de um mesmo usuário.
Definir uma quantidade máxima default de conexões por usuário.
Negar a conexão com base no usuário, grupo, dia da semana, etc.

Dentro de uma Trigger de Login você pode utilizar a função EVENTDATA() para obter informações da conexão que originou o disparo da trigger, veja o documento XML gerado abaixo:


Outras fontes de informações que podem ser utilizadas dentro da trigger:
- sys.dm_exec_sessions – View dinâmica com informações das sessões abertas.
- sys.dm_exec_connections – View dinâmica com informações das conexões abertas.
- app_name() – nome da aplicação utilizada para realizar a conexão corrente
- CURRENT_USER – usuário de banco de dados da conexão corrente

Exemplo:
-- Retorna Informações da conexão corrente
select s.*,c.*
from sys.dm_exec_sessions s
join sys.dm_exec_connections c
on s.session_id = c.session_id
where s.session_id = @@spid

O exemplo abaixo cria uma Trigger de Login que restringe o acesso ao servidor a partir do Management Studio apenas para o Administrador, além de registrar em uma tabela de auditoria os logins com sucesso.

-- Tabela de Auditoria na MSDB
create table msdb.dbo.AutitLogin (
idPK int not null identity,
Data datetime null,
ProcID int null,
LoginID varchar(128) null,
NomeHost varchar(128) null,
App varchar(128) null,
SchemaAutenticacao varchar(128) null,
Protocolo varchar(128) null,
IPcliente varchar(30) null,
IPservidor varchar(30) null,
xmlConectInfo xml)
go

-- Trigger de Login
create trigger AuditLogin on all server
for logon
as
IF CURRENT_USER <> 'dbo' and
app_name() like 'Microsoft SQL Server Management Studio%'
rollback
else
-- Login sucesso
insert msdb.dbo.AutitLogin
select getdate(),@@spid,s.login_name,s.[host_name],
s.program_name,c.auth_scheme,c.net_transport,
c.client_net_address,c.local_net_address,eventdata()
from sys.dm_exec_sessions s join sys.dm_exec_connections c
on s.session_id = c.session_id
where s.session_id = @@spid
go

Se um usuário comum tentar abrir uma conexão no SQL Server a partir do Managemente Studio irá receber a mensagem de erro abaixo:


A mensagem de erro poderia ser melhor, sem expor o motivo da falha da conexão: “trigger execution”! Você pode votar no site Microsoft Connect para alterar a mensagem de erro no link abaixo:
https://connect.microsoft.com/SQLServer/feedback/Vote.aspx?FeedbackID=237008

Gostaria de agradecer a Diego Cerqueira (o aluno especializado em Oracle) por ter enriquecido a aula com sues questionamentos, dando origem a este post.

Até o próximo post,
Landry.